# Digercules
Digercules היא תוכנה עם רכיבי רשת נוירונית שלוקחת כל ערימה גולמית ולא ממוינת של קבצים — ארכיון, ספרייה, הקלטות קונצרטים, תכתובת במסרים מיידיים — והופכת אותה לספרייה מובנית, כולל דה-דופליקציה חכמה: מציאת כל עותק של אותו דבר, הסרת העודף, ושום דבר חשוב לא אובד. לכל קובץ בנפרד — נושא, שפה, סוג מסמך, ישויות מפתח, תקציר. זה נעשה מראש, בלי לחץ ובלי דדליין, לפני שמישהו זקוק לזה בדחיפות — לא ברגע האחרון תחת לחץ למשימה ספציפית. את הספרייה המוכנה אפשר להזין לכל רשת נוירונים, מסד נתונים או מנוע חיפוש — מכאן הם ממשיכים לבד, מוצאים את הנדרש ובונים את הממשק; Digercules לא מחליפה את השלב הבא הזה, היא הופכת אותו לאפשרי מלכתחילה, בכך שהיא לוקחת על עצמה את ההכנה הדורשת עבודה רבה שלעולם אין לה משאבים.
נתונים מעובדים ללא ענן ארגוני — או לגמרי על המחשב של הלקוח (בהינתן עוצמת GPU מספקת), או שלמחבר התוכנה נשלחים, לא הקבצים המקוריים, אלא עותקים דחוסים שהוכנו במיוחד לזיהוי, כאשר רק טקסט חוזר בחזרה.
כבר הוכח על ארכיונים בקני מידה שונים — סטטיסטיקה אמיתית מפרויקטים שעובדו:
+800,000
קבצים עובדו
כ-85 טרה-בייט
נפח המקור
+66,000 שעות
אודיו (כ-7.5 שנים)
1.8 טרה-בייט
שוחררו בדדופליקציה
3,507 שעות
הושקעו בעיבוד
~430
מבצעים זוהו בווידאו
בערוץ התקשורת הזמין (כ-30 מגהביט לשנייה, נמדד בפועל) העלאת נפח כזה לענן הייתה אורכת כ-262 ימים — לעומת 96 הימים שבהם זה עובד בפועל במקום. האחסון היה עולה מ-$84 לחודש, והעיבוד על GPU בעוצמה דומה היה עולה מ-$150–190 לחודש. וזה בלי לספור עוד שלב: הנתונים עדיין צריכים לעבור מהאחסון אל מכונת ה-GPU עצמה לצורך העיבוד — גם בערוץ מהיר פי שלושה (100 מגהביט לשנייה), אצווה של כמה טרה-בייט לוקחת בערך 3 ימים.
## מה באמת רץ מתחת למכסה המנוע
Digercules הוא לא מודל אחד — זהו תהליך מתוזמר של יותר מ-25 שלבי עיבוד, כל אחד עושה משימה צרה אחת היטב, כשהפלט של אחד הופך לקלט של הבא.
**דיבור לטקסט.** אודיו ווידאו עוברים דרך `faster-whisper` (large-v3-turbo): קודם מעבר מהיר להתאמה ומיון, ואז מעבר עיקרי איטי וקפדני יותר עם הנחיות מודרכות שנבנות מאוצר המילים של הארכיון עצמו. כשלארכיון יש קבוצת קולות חוזרת משלו או מינוח ייחודי חוזר, ניתן לכייל את המודל (LoRA) בדיוק על אותו קורפוס — הוכח על יותר ממאה שעות של אוסף אחד ספציפי.
**זיהוי קול.** מודל embedding קולי (ECAPA-TDNN) בונה גלריית קולות — מי מדבר, בהשוואה לכל מי שהמערכת כבר שמעה — הגלריה גדלה עם כל ארכיון שמעובד.
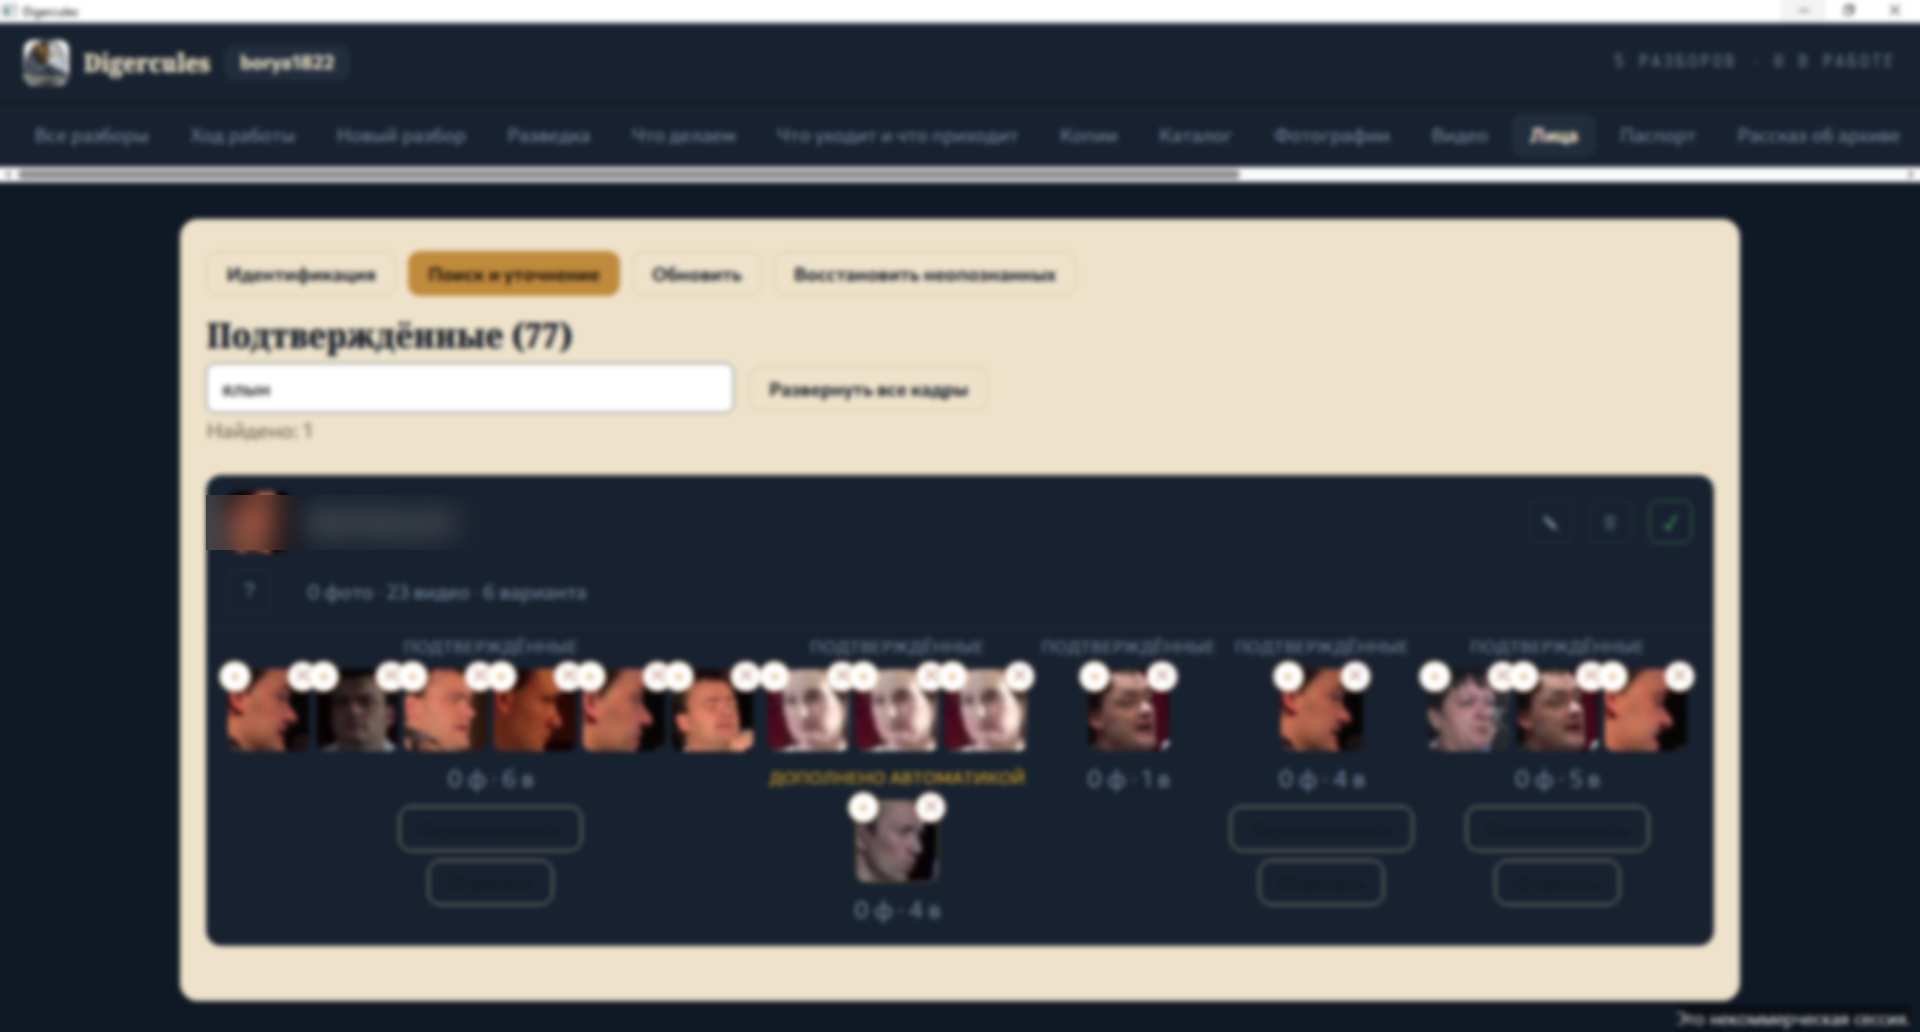
**זיהוי פנים.** אותו עיקרון כמו זיהוי קול, על פנים: גלריה עם מספר אבות-טיפוס לכל אדם — מסוגלת למה שפרצוף ממוצע יחיד לא יכול: לזהות את אותו אדם שצולם כילד וגם ארבעים שנה מאוחר יותר. מסך האישור נבחן על 20 טרה-בייט של צילומי קונצרטים אמיתיים.
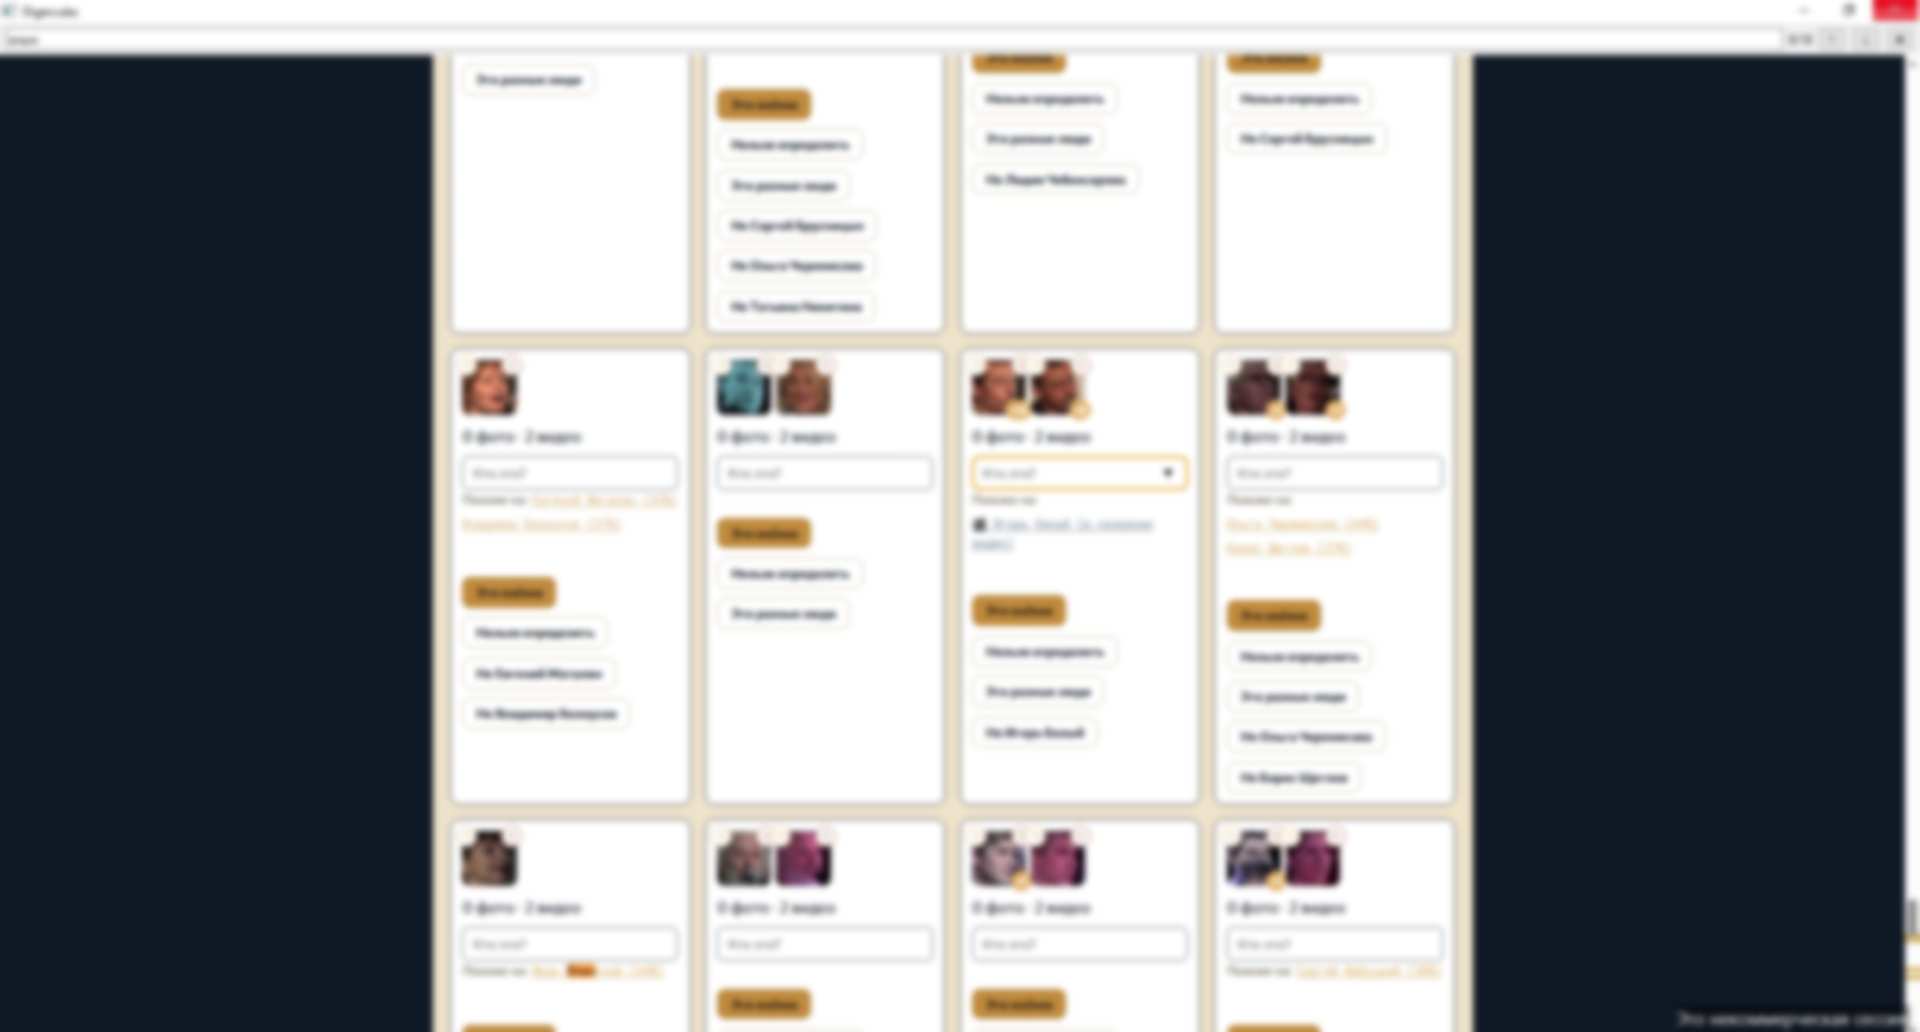
מסך הסקירה: כל הופעה מאושרת של פרצופו של אדם אחד, מקובצת לפי סרטון.אותו מסך באמצע הסקירה: המערכת מציעה התאמה עם ציון דמיון, ואדם מאשר או דוחה אותה.
ההחלטה תמיד ביד אדם: דמיון הוא רמז עם אחוז, לא תשובה סופית, ואין סף בטוח שממנו אפשר לסמוך עליו אוטומטית — הממשק לא מסתיר את זה. פרצוף שאף אחד לא מזהה לא מוצג כמזוהה — הוא ממתין למי שמכיר את הארכיון טוב יותר. [עוד על איך המודול עובד](https://digercules.com/he/face-identification/).
**OCR.** מסמכים סרוקים עוברים דרך Marker — מנוע קוד-פתוח לזיהוי והמרת PDF/סריקות — שהופך עמוד מצולם לטקסט הניתן לחיפוש, לא רק תמונה עם אותיות.
**הבנת תמונות, בשכבות.** כל בנק תמונות עובר תחילה מעבר זול, CPU בלבד (OpenCV DNN — EAST לאזורי טקסט, YuNet לספירת פנים), שרץ באופן זהה על כל מחשב בצי, כולל חומרת Windows 7 בת עשור. על חומרה חדשה יותר, מעבר שני מוסיף סיווג סצנה CLIP zero-shot במהירות GPU. במקום שבאמת חשוב, מודל שפה-חזותי מלא (Ollama) כותב תיאור אמיתי לכל תמונה. שלוש שכבות, הזולה קודם.
**הבנת מסמכים.** כל קובץ נקרא ומתואר על ידי מודל שפה מקומי (Ollama): על מה הוא, באיזו שפה, בשביל מה הוא באמת.
**דה-דופליקציה שגם מגנה על הקבצים שלך.** אותו hash שמוצא עותקים כפולים גם מאמת, בייט אחר בייט, שקובץ שחוזר לארכיון שלך אחרי העיבוד הוא בדיוק אותו קובץ שיצא ממנו.
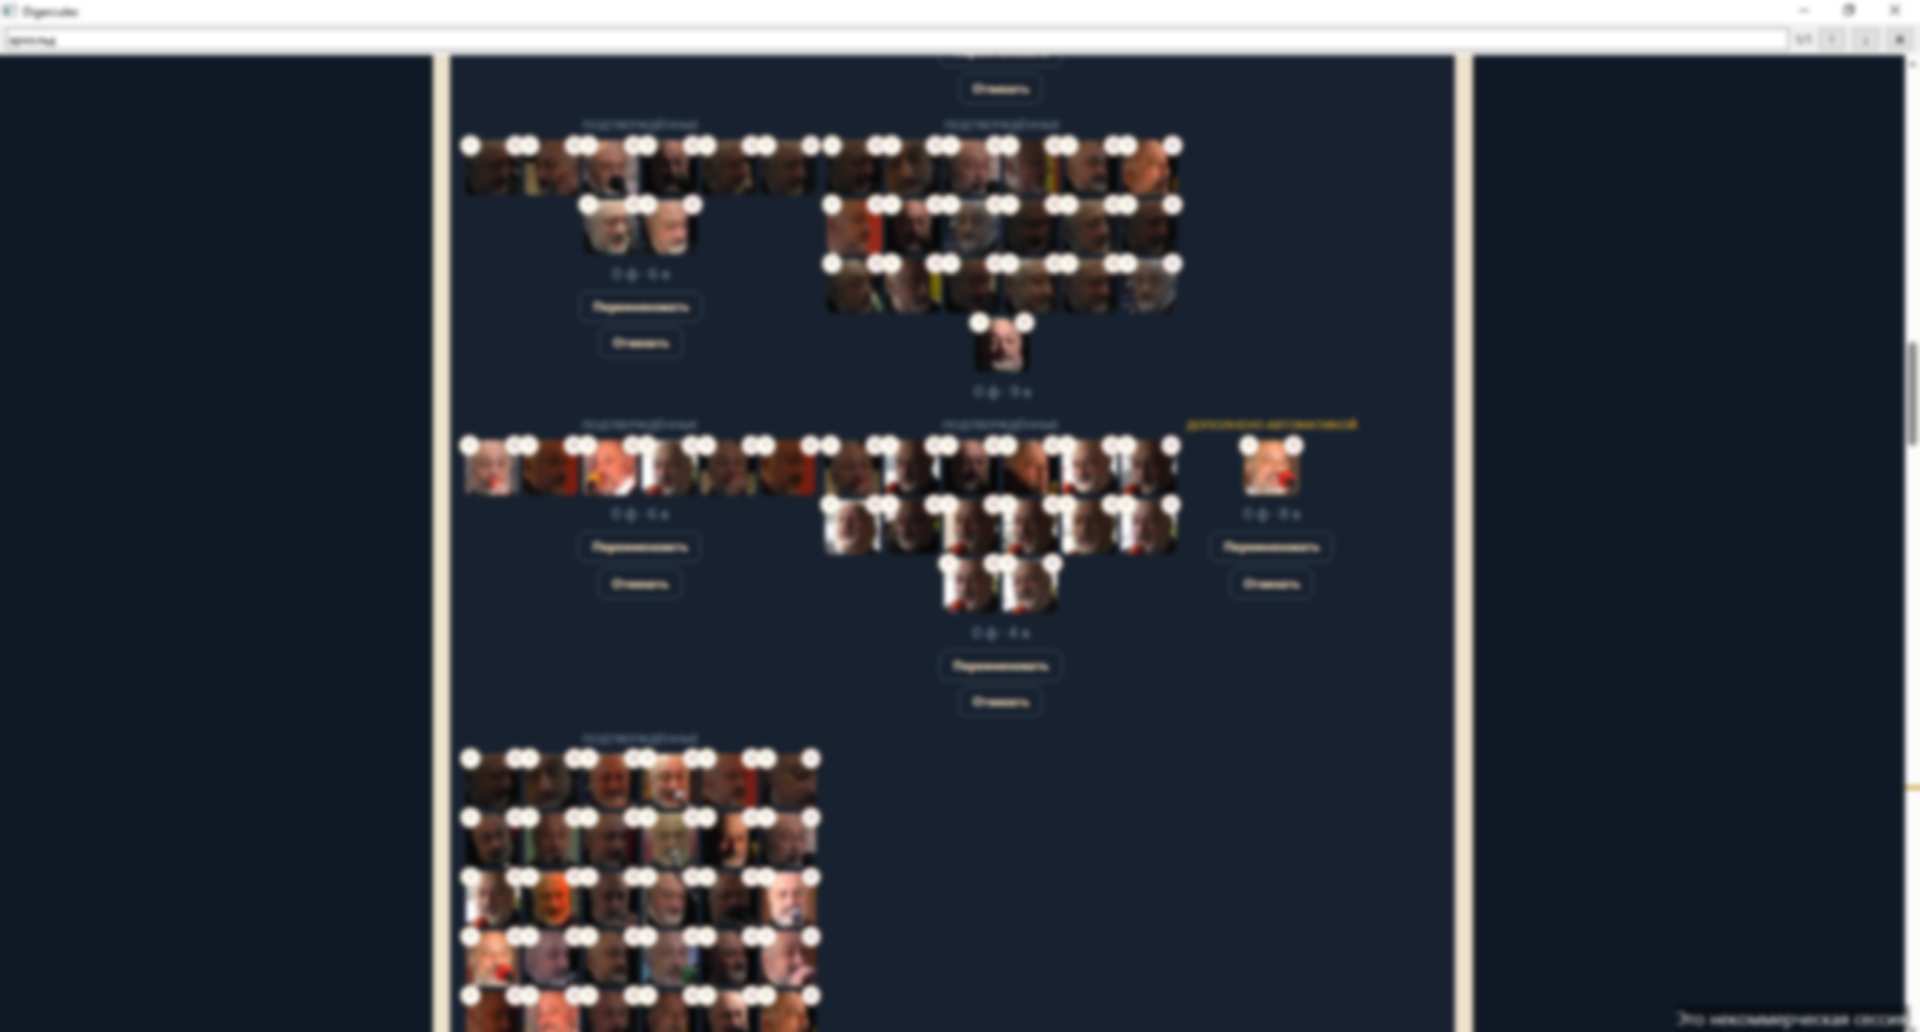
קנה מידה, בארכיון אמיתי אחד: מאות וריאציות פנים מזוהות, מקובצות אוטומטית ומדויקות בידי אדם.
כל אחד מהשלבים האלה רץ מקומית או על מכונה ספציפית ומזוהה שאתם בוחרים — אף פעם לא בענן אנונימי.
## סטטוס
המוצר בפיתוח פעיל. הספרייה ההנדסית יציבה, בייצור.
## גיאוגרפיה של הצוות
הפיתוח מתבצע על ידי צוות מבוזר בכמה מדינות: ישראל, גאורגיה, רוסיה. נקודות נוכחות אמיתיות של תשתית המחשוב: ראשון לציון, ישראל · טביליסי, גאורגיה · צ'ליאבינסק, רוסיה · מוסקבה, רוסיה.
## לאן הלאה
Digercules משרת סוגים שונים של לקוחות דרך אתרים נפרדים:
- **[digercules.ru](https://digercules.ru/)** — צרכנים רוסיים, ארכיון הופעות חיות (שירי בארד ועוד)
- **[digercules.org](https://digercules.org/he/)** — הצעות לארגונים
- **[digercules.net](https://digercules.net/he/)** — לקוחות פרטיים, מקרי שימוש ספציפיים
## איך זה מתומחר
הרצה מקומית ועצמאית היא רכישה חד־פעמית של הכלי בלי הגבלה על נפח הארכיון; רק ההערכה המקדימה, לפי תיאור או צילום מסך של הארכיון, היא בחינם. תיאום כבד יותר, כשהכוח שלכם לא מספיק, הוא בנפרד ונקבע לפי הנפח בפועל של העבודה שנמצאה — היום אין לזה מספר קבוע. לאסמכתא מהשוק, ראו את הנתונים למעלה בעמוד הזה (כמה הייתה עולה משימה דומה דרך ענן רגיל). פרטים לכל תרחיש נמצאים ב-[digercules.org](https://digercules.org/he/) וב-[digercules.net](https://digercules.net/he/).