 Digercules
Digercules es un programa con componentes de redes neuronales que toma cualquier montón desordenado de ficheros — un archivo, una biblioteca, grabaciones de conciertos, correspondencia de mensajería — y lo convierte en una biblioteca estructurada, incluyendo deduplicación inteligente: encontrar todas las copias de lo mismo, eliminar lo sobrante y no perder nada importante. Por cada archivo — un tema, un idioma, un tipo de documento, entidades clave, un resumen breve. Esto se hace de antemano, sin prisas ni plazos, antes de que a nadie le urja — no en el último momento bajo presión por una tarea concreta. La biblioteca terminada puede alimentar a cualquier red neuronal, base de datos o sistema de búsqueda — a partir de ahí ellos mismos encuentran lo necesario y construyen la interfaz; Digercules no reemplaza ese siguiente paso, lo hace posible desde el principio, asumiendo esa preparación laboriosa para la que nunca hay recursos suficientes.
Los datos se procesan sin nubes corporativas — o bien enteramente en el propio equipo del cliente (si cuenta con la GPU necesaria), o bien al autor del programa no se le envían los archivos originales, sino copias comprimidas preparadas específicamente para el reconocimiento, y solo vuelve texto.
Ya comprobado en archivos de diversa escala — estadísticas reales de proyectos procesados:
Por el canal disponible (~30 Mbit/s, medido) subir este volumen a la nube tardaría unos 262 días — frente a los 96 que realmente llevó procesarlo en el sitio. El almacenamiento costaría desde $84/mes, y el procesamiento en una GPU comparable costaría desde $150–190/mes. Y eso sin contar el siguiente paso: los datos igualmente hay que moverlos del almacenamiento a la propia máquina con GPU para procesarlos — incluso por una conexión tres veces más rápida (100 Mbit/s), un lote de varios terabytes tarda unos 3 días.
Lo que realmente funciona por dentro
Digercules no es un solo modelo — es un proceso orquestado de más de 25 fases, cada una resolviendo una tarea concreta, donde el resultado de una alimenta a la siguiente.
Voz a texto. El audio y el vídeo pasan por faster-whisper (large-v3-turbo): primero una pasada rápida para cotejar y priorizar, luego una pasada principal, más lenta y cuidadosa, con indicaciones guiadas construidas a partir del propio vocabulario del archivo. Cuando un archivo tiene su propio elenco recurrente de voces o su propia terminología particular, el modelo puede ajustarse (LoRA) específicamente a ese corpus — comprobado sobre cientos de horas de una misma colección.
Identificación de voz. Un modelo de embeddings de voz (ECAPA-TDNN) construye una galería de voces: quién habla, comparado con todo lo que el sistema ya ha escuchado antes — la galería crece con cada archivo procesado.
Identificación de rostros. La misma lógica que la identificación de voz, aplicada a rostros: una galería con varios prototipos por persona — capaz de algo que un único rostro promediado no puede: reconocer a la misma persona fotografiada de niño y cuarenta años después. La pantalla de confirmación se ha probado sobre 20 TB de grabaciones reales de conciertos.
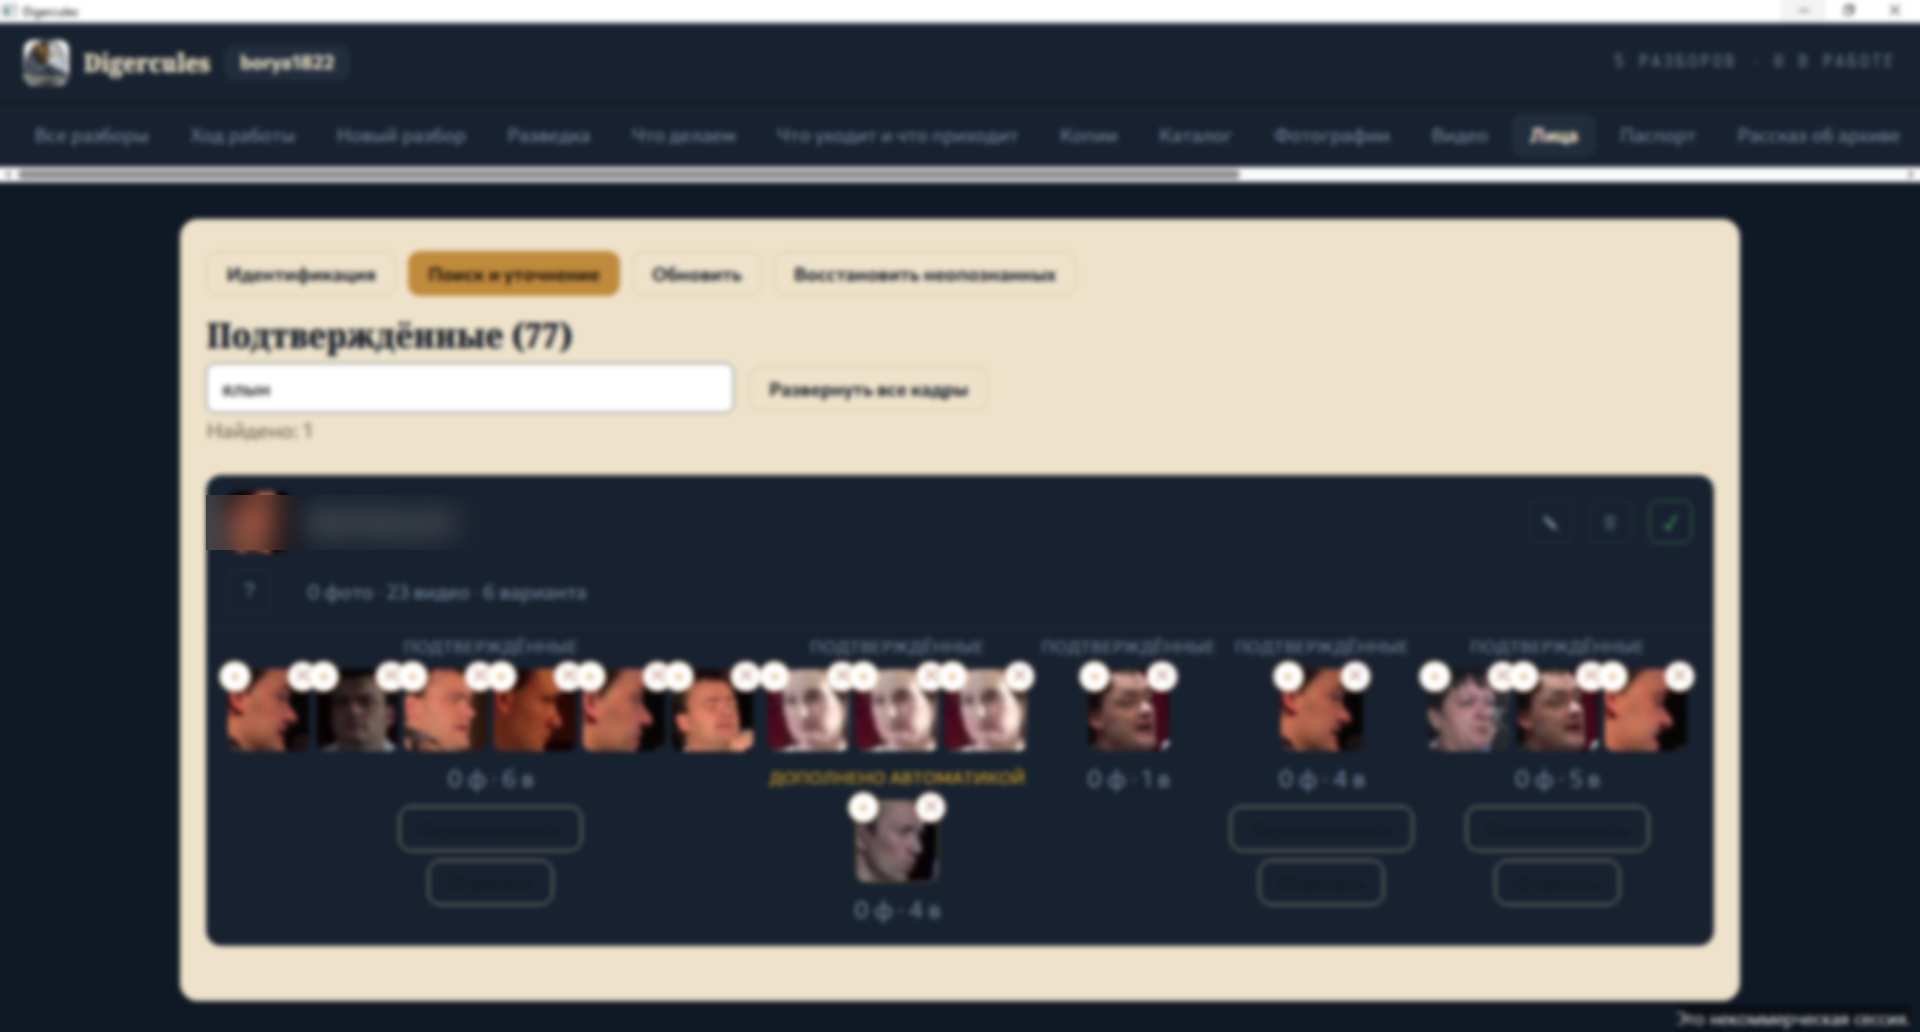
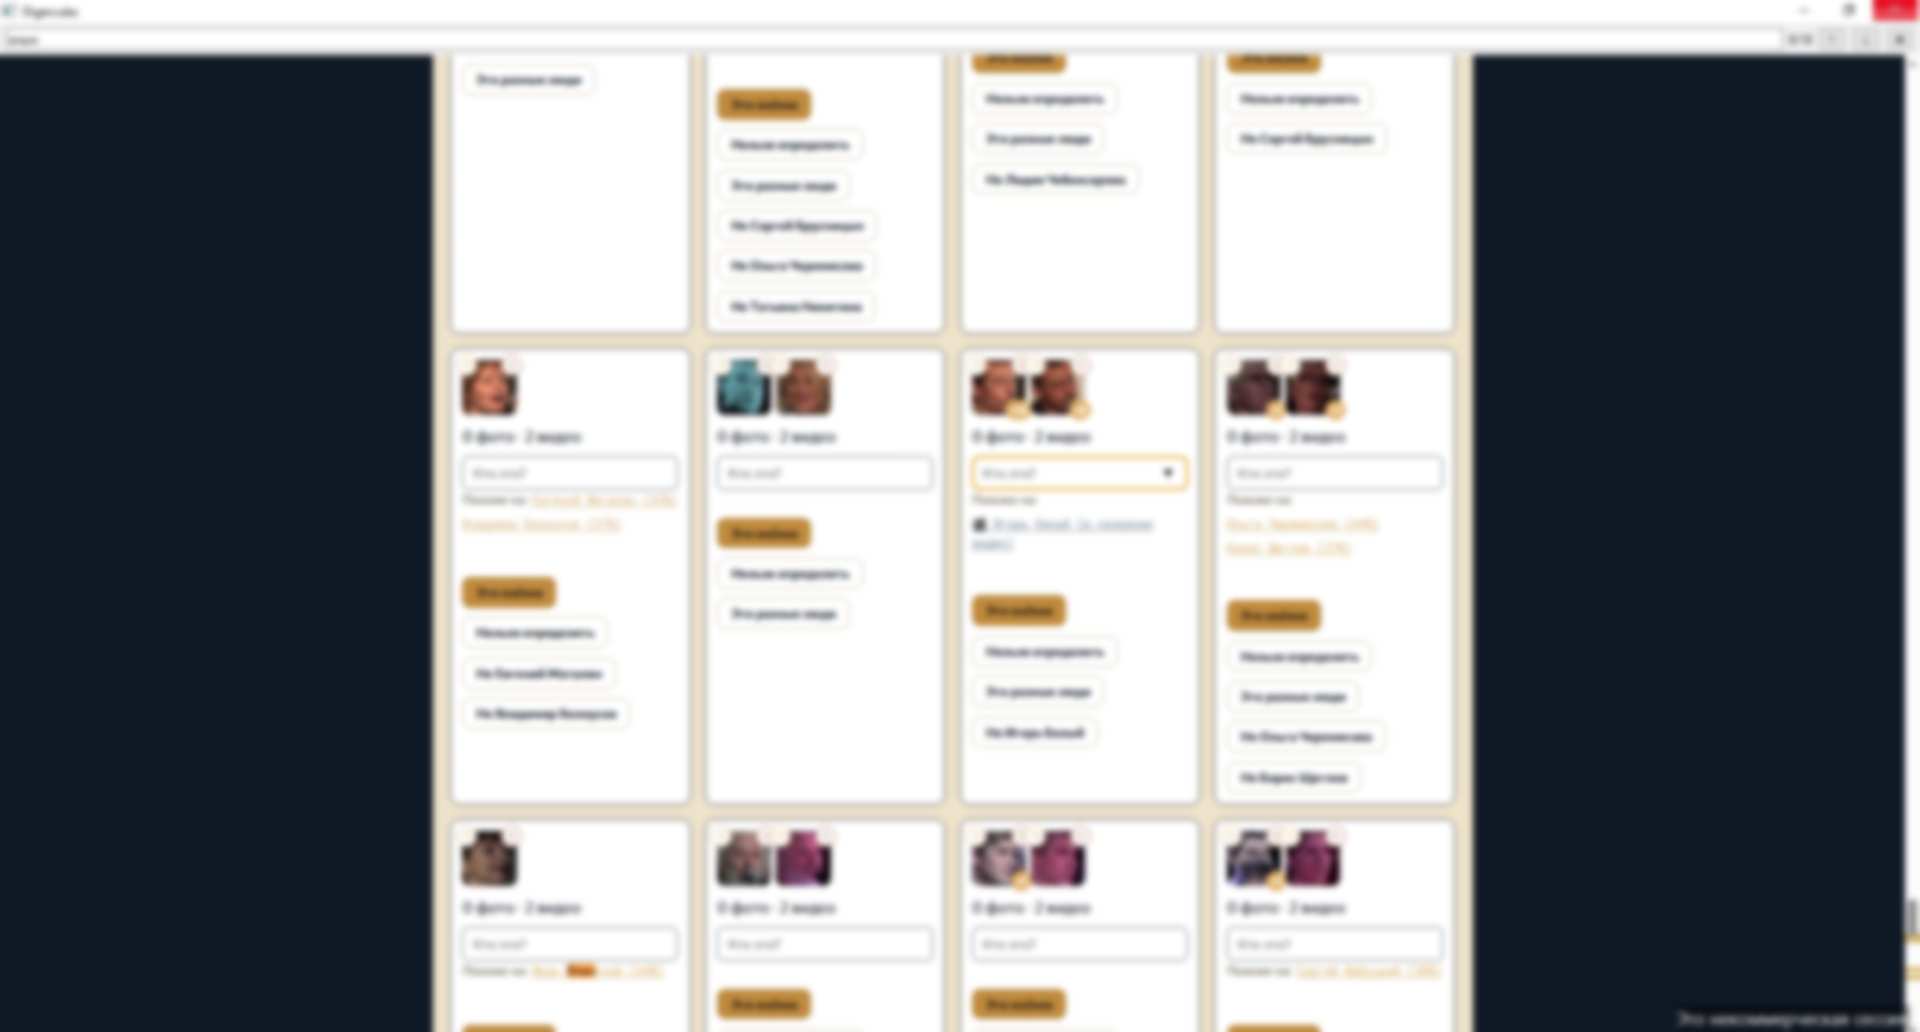
La decisión es siempre de la persona: la similitud es una pista con un porcentaje, no una respuesta terminada, y no existe un umbral seguro a partir del cual se pueda confiar en ella automáticamente — la interfaz no lo oculta. Un rostro que nadie reconoce no se hace pasar por identificado; espera a quien conoce mejor el archivo. Más sobre cómo funciona el módulo.
OCR. Los documentos escaneados pasan por Marker — un motor de reconocimiento y conversión de PDF/escaneos de código abierto — convirtiendo una página fotografiada en texto buscable, no solo en una imagen con letras.
Comprensión de fotografías, por niveles. Cada banco de fotos pasa primero por una pasada barata, solo CPU (OpenCV DNN — EAST para regiones de texto, YuNet para conteo de rostros), que funciona igual en cualquier máquina de la flota, incluido hardware con Windows 7 de una década de antigüedad. En hardware más reciente, una segunda pasada añade clasificación de escena CLIP zero-shot a velocidad de GPU. Donde de verdad importa, un modelo visión-lenguaje completo (Ollama) escribe una descripción real de cada foto. Tres niveles, el más barato primero.
Comprensión de documentos. Cada archivo se lee y se describe mediante un LLM local (Ollama): de qué trata, en qué idioma, para qué sirve realmente.
Deduplicación que además protege tus archivos. El mismo hash que encuentra copias duplicadas también verifica, byte a byte, que un archivo que vuelve a tu archivo tras el procesamiento es exactamente el mismo que salió de él.
Cada una de estas fases se ejecuta localmente o en una máquina concreta, nombrada, que tú eliges — nunca en una nube anónima.
Estado
El producto está en desarrollo activo. La biblioteca de ingeniería está estable, en producción.
Geografía del equipo
El desarrollo lo realiza un equipo distribuido en varios países: Israel, Georgia, Rusia. Puntos reales de presencia de la infraestructura de cómputo: Rishon LeZion, Israel · Tbilisi, Georgia · Cheliábinsk, Rusia · Moscú, Rusia.
A dónde ir después
Digercules atiende a distintos tipos de clientes a través de sitios independientes:
- digercules.ru — consumidores rusos, archivo de actuaciones en vivo (canción de autor y más)
- digercules.org — propuestas para organizaciones
- digercules.net — clientes particulares, casos de uso concretos
Cómo se paga esto
Una pasada local y autónoma es una compra única de la herramienta sin límite de volumen de archivo; solo la valoración preliminar, a partir de una descripción o captura del archivo, es gratuita. La coordinación más pesada, cuando la capacidad propia no basta, va aparte y se fija según el volumen de trabajo realmente encontrado — hoy no hay una cifra fija para eso. Como referencia de mercado, vea las cifras más arriba en esta página (lo que costaría una tarea comparable a través de una nube corriente). Los detalles de cada escenario están en digercules.org y digercules.net.